从菜鸟驿站到操作系统:一节课彻底打通 Linux 重定向、VFS 与缓冲区
少年们,如果你曾疑惑过:为什么 ./a.out > log.txt 时错误信息依然赖在屏幕上?为什么 fork() 之后文件里突然冒出 7 行输出?为什么 printf 明明返回了,数据却可能没落盘?这节课的目标,就是把这些黑盒砸碎,把从 C 语言标准库到操作系统内核的数据流动路线,彻彻底底地画在你的脑子里。
一、重定向的本质:不是“箭头”,而是文件描述符的“偷天换日”
1.1 “标准输出”和“标准错误”为什么分得那么清?
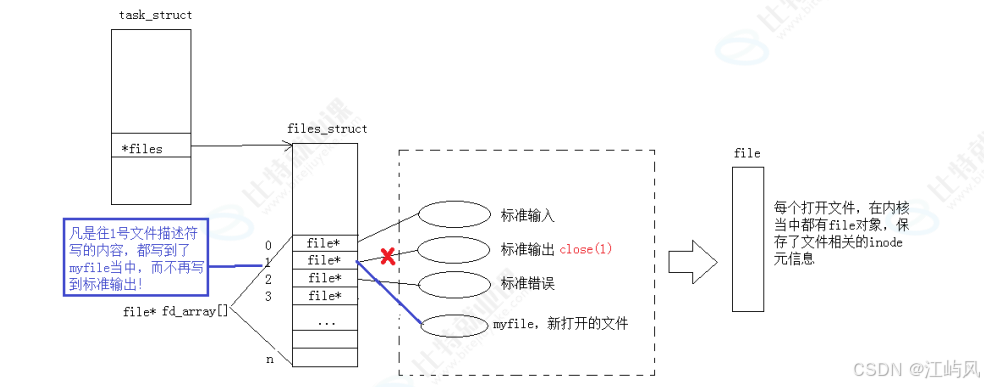
每当一个进程被启动,操作系统都会在背后悄悄打开三个文件描述符(fd):
- 标准输入(stdin) :fd = 0
- 标准输出(stdout) :fd = 1
标准错误(stderr) :fd = 2
敲黑板: 虽然 stdout 和 stderr 默认都对着你的显示器,但它们各自持有一个独立的 fd——可以想成两根不同的水管,只不过出水口恰好都通向同一个池子。
为了证明这一点,课上写了一段 C/C++ 混编的代码:
#include
#include

int main() {
    std::cout
编译跑起来之后,屏幕上自然出现了 4 行输出。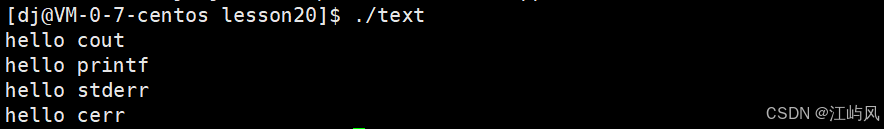
接着换成这条命令:
./a.out > log.txt你会看到的结果是:stdout 的内容乖乖进了文件,而 stderr 的内容照样大摇大摆地留在屏幕上。
原因在哪? > 这个符号真正干的事情是:先打开一个新文件,拿到一个新的 fd(假设是 3),然后把 fd 里保存的指针内容 复制 到 fd=1 的位置上。整个过程中它只碰了 1,没有碰 2。于是 fd=2 依旧稳稳地指向显示器。(前面两个属于标准输出路径的库函数,本来是直接写到显示器的;现在 1 号槽位被替换成了指向 log.txt 的指针,于是原本发往显示器的数据自然就改道去了 log.txt)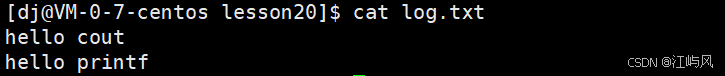
1.2 合并重定向的正确姿势与深坑
📌单独看 "1>log.txt" 这个写法:它的实际含义就是把指向 log.txt 的指针拷贝到文件描述符表里下标为 1 的那个槽位里。
要是希望 stdout 和 stderr 各自落到不同的文件,可以这么写:
(前面两个必须立刻刷新缓冲区)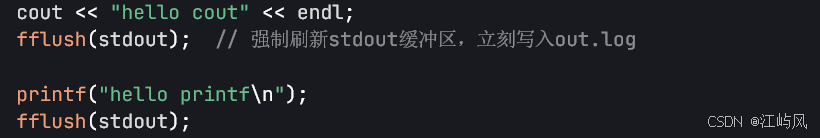
./a.out 1> out.log 2> err.log那如果想把两者合并到 同一个文件 里呢?不少同学的第一反应是:
./a.out > log.txt 2>> log.txt老师在这个地方重重地敲了黑板: 千万别这么写! 第一次重定向打开文件时执行的是 截断清空 ;第二次换成追加模式打开,内容固然能写进去,然而这属于两次独立的 open 调用,文件偏移量和写入先后次序都变得不可控,极容易出现互相覆盖或者顺序错乱的问题。
真正推荐的方式 是这样:
(一定注意别手滑多打空格,否则一个命令就被拆散了)
./a.out 1> log.txt 2>&1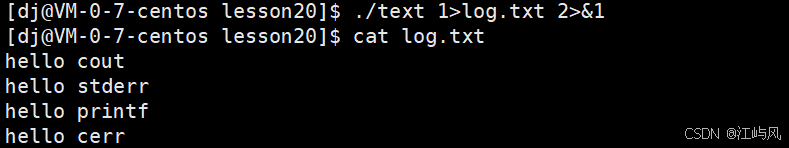
它表达的含义是:先让 fd=1 指向 log.txt ;随后让 fd=2 去指向 fd=1 此刻所指向的那个文件 。这样一来,1 和 2 最终共享同一个文件实体,两次打开导致的竞争问题也就被绕开了。
1.3 为什么要搞出 stderr 这个东西?
这是个很多同学(包括当年听课的我)都会冒出来的疑问:不都是往显示器上打吗?分那么清楚图什么?
答案是: 为了让常规消息和错误消息能够被分开处理。
程序输出日志存在两类需求:一类是业务运行中必须打印的正常信息;另一类是为了排查问题而输出的错误信息。这两者要是混在一起,你 debug 的时候就得在茫茫正常日志里大海捞针。有了 stderr,我们就可以借助重定向能力,把正确流和错误流做“物理隔离”,各自形成独立的日志文件。这也正是 perror 、 cerr 这些接口存在的设计根基。
二、“一切皆文件”的底气:VFS (Virtual File System”(虚拟文件系统)) 与 C 语言写出的“多态”
2.1 从 PCB 到 file(FILE* 那个返回值) 结构体
上一节课我们已经搞清楚 fd 本质上就是数组下标。这一节课老师带着我们翻开了 Linux 2.6 内核源码( task_struct → files_struct → file ),确认了这个数组里存放的确实是指向 struct file 的指针。
那么 struct file 里面都装了哪些关键信息?
- 引用计数 (f_count):用来记录当前有多少个 fd 正指向这个文件对象;
- 读写位置 (f_pos):老师在这里说了一句让人瞬间通透的话—— “不管你是文本文件还是二进制文件,在我眼里统统是
char类型的一维数组!”f_pos就是你当前读写到了这个数组的第几个元素; - 内核缓冲区 :顺着
struct file能找到该文件对应的内核级缓冲(和 page cache 相关); - inode 指针 :文件的硬属性(大小、权限、ACM 时间)并不直接存放在
file里,而是存放在inode中,通过file间接定位。
2.2 不同硬件的读写方法天差地别
操作系统底层面对的都是些什么?磁盘、显示器、键盘、鼠标、网卡……每种硬件的 I/O 方式都截然不同:
- 读磁盘:需要磁头寻道、盘片旋转、DMA……
- 写显示器:往显存映射区写入数据……
读键盘:扫描码、中断……
问题就来了: 假如让用户进程直接面对这些差异,那么每访问一种硬件就得换一套接口,程序根本没法写。
2.3 VFS(Virtual File System”(虚拟文件系统)):加一层软件层,屏蔽一切差异
这里老师引用了软件工程领域的一句经典名言:
“任何计算机问题都可以通过增加一层软件层来解决。”
于是 Linux 在内核中铺了一层 VFS(Virtual File System,虚拟文件系统) 。
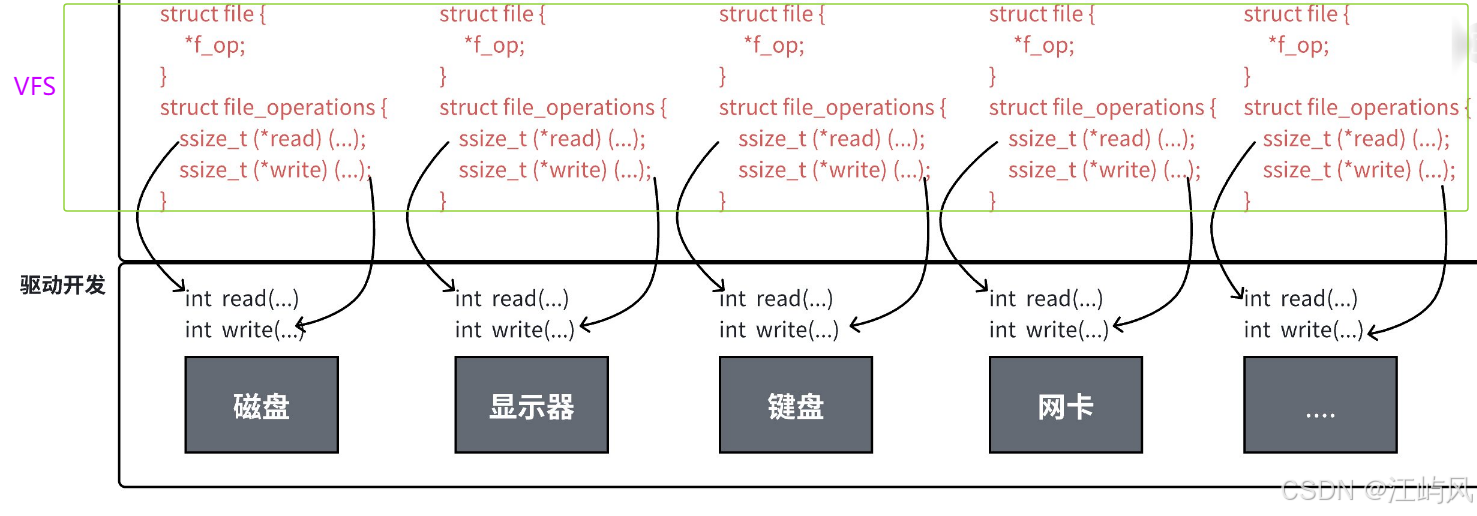
在 struct file 中,存在一个名为 f_op 的成员,它是个指针,指向 struct file_operations :
struct file {
    // ...
    const struct file_operations *f_op;
    // ...
};

struct file_operations {
    ssize_t (*read)(struct file *, char __user *, size_t, loff_t *);
    ssize_t (*write)(struct file *, const char __user *, size_t, loff_t *);
    // ...
    //存的是I/O方法的函数指针
};
当进程打开某个设备文件时,内核会依据设备类型,把 f_op 指向 该设备驱动所提供的具体函数 :
- 打开磁盘文件 →
f_op->read指向磁盘的读方法; - 打开显示器 →
f_op->write指向显存的写方法; 打开键盘 →
f_op->read指向键盘驱动的读方法……上层用户只管调用统一的
read、write,底层则通过函数指针动态绑定到不同的硬件实现上去。
2.4 C 语言实现的多态
老师在这里激动地写下了一行结论: “这就是多态!”
C 语言没有 class ,没有虚函数,但它靠着 结构体 + 函数指针 完美实现了面向对象中的多态特性。C++ 的虚函数表,本质上也不过是一张函数指针表;操作系统内核早在 C++ 普及之前,就用这套手法把硬件差异抹平了。
因此, “一切皆文件”并非一句空洞的口号 ,它的真实含义是:进程被蒙在鼓里了——它以为自己操作的是“文件”,实际上操作的是 VFS 层统一抽象出来的 struct file ;内核再通过函数指针,把请求分发到磁盘、显示器、网卡等完全不同的驱动上去。
三、缓冲区机制:藏在 printf 背后的速度与陷阱
3.1 什么是缓冲区?
老师给出的定义简洁有力:
缓冲区,就是内存中的一段空间。
但真正的重点在于:缓冲区可不止一层。从用户代码到硬件,数据要跨越两个主要的缓存站:
- 用户级缓冲区 :由 C 标准库(glibc)管理,藏在
FILE结构体里。printf、fprintf、fwrite先把数据写到这里; - 内核级缓冲区 :由 OS 内核维护,与
struct file相关联。write系统调用把数据从用户空间拷到这里,之后再由 OS 决定何时刷到硬件。
3.2 为什么需要缓冲区?菜鸟驿站模型
为了把这个道理讲透,老师用了一个非常生活化的比喻—— 菜鸟驿站 。
假设没有菜鸟驿站(也就是没有缓冲区):
- 你就是用户,快递员(OS)每送来一个包裹(数据),都得在楼下打电话等你,你必须立刻下楼去取。可万一你正在忙更重要的事(CPU 正在执行计算),就会被频繁打断。
- 快递员那边也一样,每次都得等你,一天下来送不了几个件。
而有了菜鸟驿站(引入缓冲区)之后:
快递员把包裹批量往驿站一丢,不用等你;
你什么时候得空了,下楼一次性拿一大摞。
映射到计算机世界里:
用户级缓冲区 :减少系统调用的次数。 printf 十次,可能只触发一次 write ;
内核级缓冲区 :操作系统也不必每次都去打扰硬件,攒够一批再统一写盘。
说到底,缓冲区存在的根本目的就是提高使用者和系统的效率。
3.3 三种刷新策略
| 策略 | 触发条件 | 适用场景 | 备注 |
|---|---|---|---|
| 无缓冲/立即刷新 | 写立即刷 | stderr(默认) | 错误信息要尽快让人看到 |
| 行缓冲 | 遇到 \n 或缓冲区满 | 标准输出到显示器 | 尊重人类“一行一行阅读”的习惯 |
| 全缓冲 | 缓冲区写满才刷 | 普通文件操作 | 效率最高,系统调用次数最少 |
一个隐藏极深的知识点:重定向会改变缓冲策略!
一旦把 stdout 重定向到文件,它的缓冲模式就会从 行缓冲 悄悄切换成 全缓冲 。这个细节,正是理解下面那个经典案例的钥匙。
四、经典案例:Fork 之后为什么打印了 7 条?
这是整节课最核心、也最考验理解深度的例子。老师当场写了这样一段代码:
#include
#include
#include
#include

int main() {
    printf("hello printf\n");               // 库函数(行缓冲/全缓冲取决于目标)
    fprintf(stdout, "hello fprintf\n");     // 库函数
    const char* msg1 = "hello fwrite\n";
    fwrite(msg1, 1, strlen(msg1), stdout); // 库函数

    const char* msg2 = "hello write\n";
    write(1, msg2, strlen(msg2));          // 系统调用!

    fork();  // 在程序结尾 fork
    return 0;
}
4.1 现象差异
场景 A:直接运行(向显示器打印)
./a.out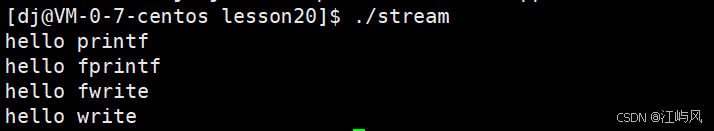
输出 4 条 。因为显示器采用行缓冲, \n 就已经触发了刷新,fork 发生之前用户缓冲区早已清空。
场景 B:重定向到文件
./a.out > log.txt
cat log.txt
输出 7 条! 而且仔细观察还会发现: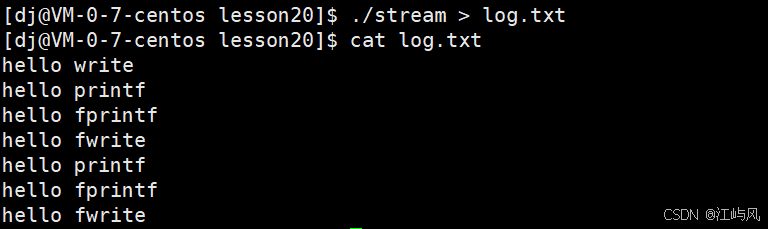
write 的内容只出现了 1 次 ;
printf 、 fprintf 、 fwrite 的内容各出现了 2 次 。
4.2 原因剖析
write 为什么只打印 1 次?
write 属于纯系统调用,它直接把数据拷贝进了 内核级缓冲区 。fork 之前,数据就已经归属于操作系统,不再留在进程的用户态内存空间里了。所以 fork 之后,不管父进程还是子进程,这份数据都不会被复制,自然只出现一次。
printf/fprintf/fwrite 为什么打印 2 次?
这三个都是 C 标准库函数 ,它们先要把数据送进 用户级缓冲区 。而执行到 fork() 的时候:
fork 会复制父进程的整个地址空间,其中 包含用户级缓冲区里的内容 ;
于是父子进程各自拿到了一份一模一样的缓冲区副本;
进程退出时,C 库会自动刷新缓冲区,父进程刷一次,子进程再刷一次,同样的内容就被写了两遍。
为什么显示器上是 4 条,文件里却是 7 条?
原因就在于重定向到文件时,缓冲策略由 行缓冲变成了全缓冲 。数据碰到 \n 不会 立刻刷新,而是继续留在用户级缓冲区里,直到 fork 之后才分别被刷出,于是发生了复制。
4.3 补充验证:提前关闭 fd 导致数据丢失
老师还回顾了上一节课的一个例子:
close(1);                           // 关闭 stdout
int fd = open("log.txt", O_CREAT|O_WRONLY|O_APPEND, 0666);
printf("hello bit\n");
// close(fd);  // 如果在 fflush 之前关闭
如果先 printf ,再 close(fd) ,最后才等到进程退出——你会惊讶地发现 log.txt 是空的!
📌这里顺便整理一下用户级缓冲区刷到内核级缓冲区的三个条件:
强制刷新
刷新条件满足
进程退出
原因在于, printf 的数据还停留在 用户级缓冲区 中,而你却提前把 fd 关掉了(刷新操作本身需要用到 fd);
进程退出时虽然想刷新,但 write(fd, ...) 发现 fd 已经失效,刷新失败,数据就这么丢了。
修复办法 :在 close 之前先调用 fflush(stdout) ,强制把语言层缓冲区先刷进内核。
五、手撕 C 标准库:模拟 fopen / fwrite / fflush
在理解了原理之后,老师带着我们亲手封装了一个 my_stdio 库。目的不是要替代 glibc,而是让你亲眼见证: 库函数的底层逻辑,不过如此 。
5.1 数据结构:MyFILE
#define MAX_BUFFER_SIZE 1024

// 刷新策略标志位
#define FLUSH_NONE   0        // 无缓冲(立即刷新)
#define FLUSH_LINE   (1
5.2 关键接口实现逻辑
my_fopen:
底层调用系统调用 open() 获取 fd;
malloc 出一个 MyFILE 对象;
初始化 outbuffer ,将 size = 0 ;
根据文件类型设置刷新策略 :如果目标是显示器( isatty ),默认设为行缓冲;如果是普通文件,则设为全缓冲。
my_fwrite:
写入的本质是什么?用老师的话说: 就是拷贝(memcpy) ;
把用户要写的字符串,按长度 memcpy 到 MyFILE->outbuffer 的尾部;
然后更新 size ;
紧接着尝试判断刷新条件 :
如果是行缓冲,检查缓冲区最后一个字符是否为 \n ,是的话就调用 my_fflush ;
如果是全缓冲,检查 size 是否已经达到 MAX_BUFFER_SIZE ,达到就调用 my_fflush 。
my_fflush:
int my_fflush(MyFILE *fp) {
    if (fp->size > 0) {
        write(fp->fd, fp->outbuffer, fp->size); // 系统调用,入内核!
        fp->size = 0;                           // 清空用户缓冲区计数
        // 可选:fsync(fp->fd) 强制刷到硬件
    }
    return 0;
}
my_fclose:
一定要 先 my_fflush ,再 close(fd) ,最后 free(fp) 。
这就对应了 glibc 在进程退出前自动扫描链表、释放 FILE 对象的逻辑。
5.3 金句:数据流动的本质只有“拷贝”
老师在课上反复强调,不要被 read 、 write 这些名字给迷惑了:
“在我看来,这个世界上只有拷贝。read 是拷贝,write 也是拷贝。数据从用户缓冲区拷贝到内核缓冲区,再从内核缓冲区拷贝到硬件,一切都是拷贝。”
计算机世界里数据流动的本质,就是 数据在各级缓冲区之间不断拷贝 。
六、那些不容忽视的小知识点
除了主线脉络之外,老师还穿插了不少容易被忽略但极有价值的细节:
fd 的上限 :默认 fd 表大小是 32 或 64,但可以通过配置扩展到 65535,后面学网络编程时就会遇到;
文件是一维数组 : fseek 、 ftell 、 rewind 本质上都是在操作数组下标 f_pos ;
引用计数 : struct file 中的 f_count 使得“一个文件被多个 fd 指向”成为可能(比如 dup2 );
内存管理 :操作系统的物理内存以 4KB(页) 为单位管理。文件的内核缓冲区也和页缓存(page cache)紧密相关;
算法题超时与缓冲区 :如果你在做 OJ 时,同样的逻辑在 C++ 里用 std::cout &1 是让错误流追随输出流。
一切皆文件 的背后,靠的是 VFS 层通过 结构体 + 函数指针 实现的多态,让进程误以为全世界都是 struct file ,从而屏蔽了硬件差异。
缓冲区存在两级 :C 库的"用户缓冲区"是为了减少你的系统调用次数;内核的"文件缓冲区"是为了减少操作系统骚扰硬件的次数。吃透 刷新策略 和 fork 复制用户空间 这两套机制,就是你日后排查各种诡异 I/O Bug 的终极武器。